
Comment les systèmes d'IA prennent des décisions : Système 1 et Système 2
Toutes les décisions d'une IA ne méritent pas le même effort de calcul. Système 1 et Système 2 offrent une analogie utile pour répartir le travail entre un modèle rapide, une politique de décision et une investigation plus lente. Voici comment je pense cette répartition, où elle atteint ses limites, et pourquoi la confiance du modèle ne doit jamais suffire à router un cas.
Sur cette page
TL;DR : Toutes les décisions d’une IA ne méritent pas le même effort de calcul. Un modèle rapide peut scorer des milliers de cas de routine pendant qu’un petit sous-ensemble reçoit une investigation plus poussée. Système 1 et Système 2 sont une analogie pratique pour cette répartition, à condition de se rappeler que c’est une analogie. Ce qui compte, c’est la politique au milieu, qui ne doit jamais router un cas sur la seule confiance du modèle.
Premier article d’une série de deux. Le deuxième explique comment les paramètres derrière une prédiction rapide sont appris.
Un processeur de paiement peut filtrer des milliers de transactions de routine par heure. Une petite partie d’entre elles demande un examen bien plus attentif. Comment répartir le travail ?
Système 1 et Système 2, c’est l’analogie à laquelle je reviens. Ces termes viennent de la psychologie cognitive et ont été popularisés par Daniel Kahneman. Le Système 1 est une cognition relativement rapide et automatique. Le Système 2 est plus lent et demande plus d’effort. Ce ne sont pas deux processeurs distincts dans le cerveau, et je ne les lirais pas non plus comme une taxonomie rigide des systèmes d’IA.
Prédictions rapides et calcul délibéré
Un modèle de type Système 1 reçoit une entrée et renvoie une prédiction directe. Un modèle de transactions peut regarder le montant, l’appareil, le lieu et l’activité récente du compte, puis produire un score de risque de fraude. Il n’a pas besoin d’écrire un raisonnement au préalable.
Un processus de type Système 2 dépense plus de calcul. Il va chercher l’historique du compte, compare des explications, vérifie des preuves, ou demande à une personne de relire. Il peut utiliser un LLM, mais aussi de la recherche, de l’optimisation, de la simulation, du logiciel classique ou une expertise humaine.
Vitesse et exactitude sont deux propriétés différentes. Un grand modèle peut faire un calcul lourd en une seule passe d’inférence, et un processus en plusieurs étapes peut quand même se tromper.
Trois façons de construire un système de décision
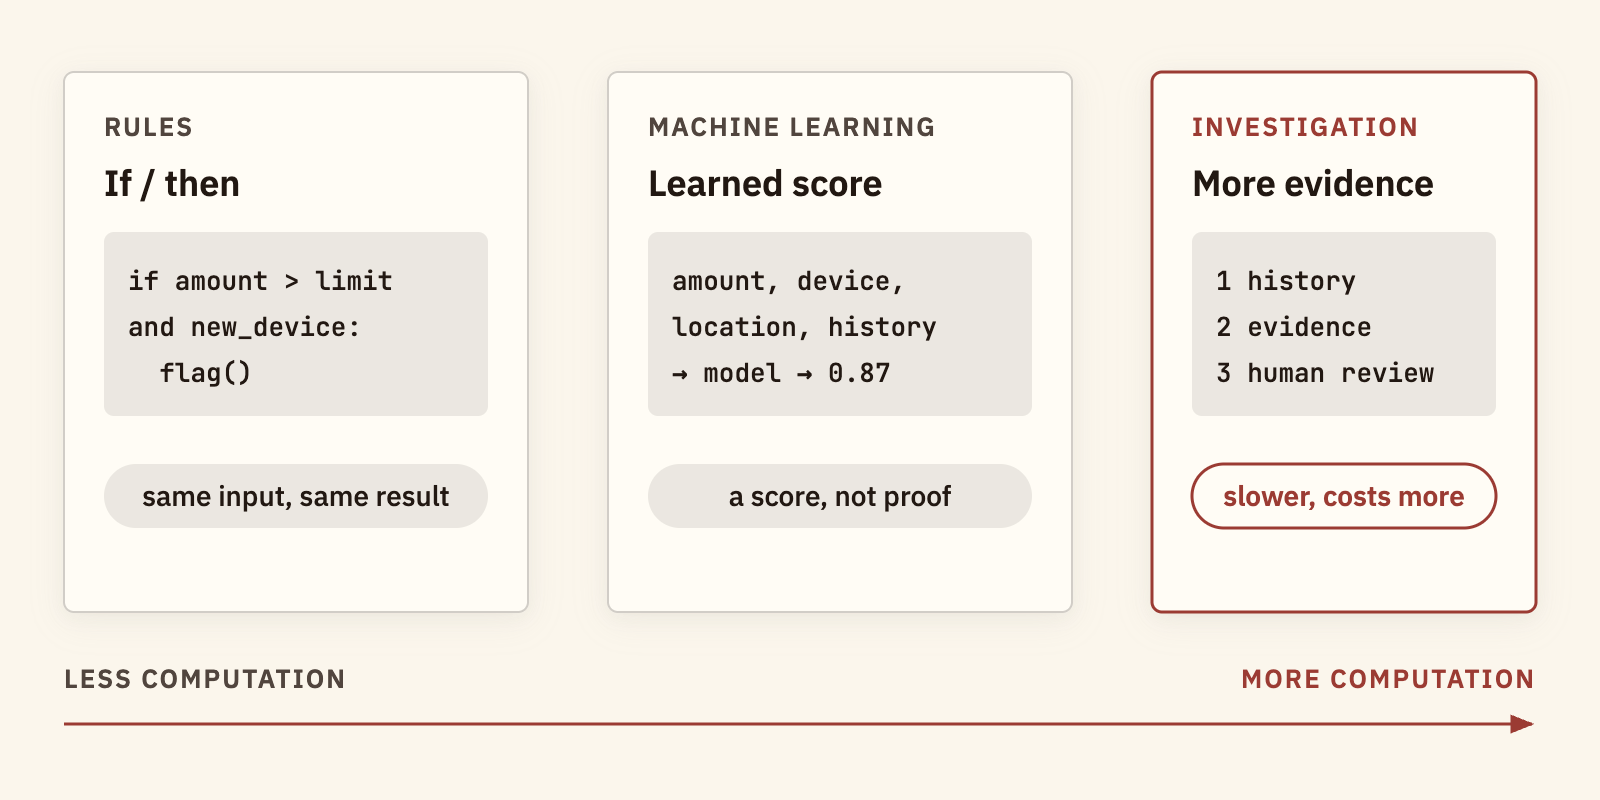
La programmation par règles. Tu écris toi-même les conditions : si le montant dépasse une limite et que l’appareil est nouveau, on signale la transaction. Les mêmes entrées et le même état donnent le même résultat. Le coût arrive plus tard, quand les exceptions s’accumulent et que les conditions commencent à interagir.
L’apprentissage automatique. Tu entraînes un modèle sur des exemples de transactions et leurs issues. Il apprend des paramètres qui relient les caractéristiques d’entrée à une prédiction. Ce score peut servir même quand aucune courte liste de règles écrites à la main ne capture le motif. Ça reste une prédiction, pas la preuve d’une fraude.
L’investigation délibérée. Le système rassemble plus de preuves et compare des alternatives avant d’agir. Il traite mieux les cas difficiles, mais il demande du temps et des ressources. Certaines décisions exigent un humain quel que soit le score du modèle.
Ces trois approches se complètent. Un moteur de règles peut imposer des contraintes strictes, un modèle peut estimer le risque, et une investigation structurée peut prendre les cas complexes.
Construire un hybride plutôt que choisir un seul mode
Prenons un flux de filtrage de transactions. Un modèle rapide produit un score initial. Une politique de décision séparée décide ensuite si le cas suit la voie de routine ou demande plus de preuves. Des entrées inhabituelles, une mauvaise qualité de données, des conséquences graves et des règles de risque indépendantes peuvent chacune envoyer un cas vers l’investigation ou vers une personne.
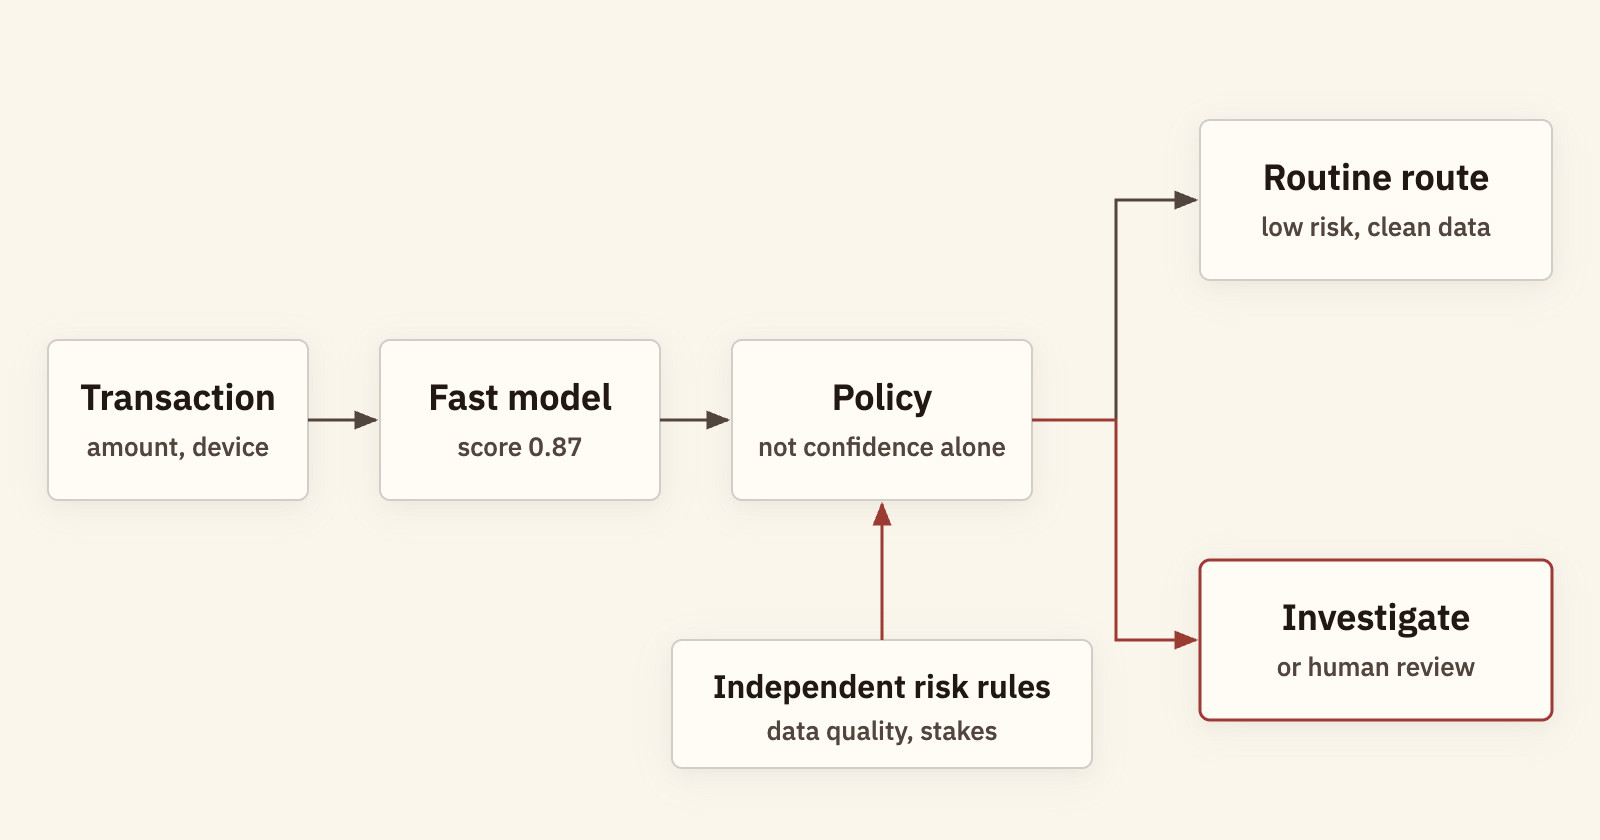
Ne route pas les cas sur la seule confiance du modèle. Un modèle peut se tromper avec assurance, surtout quand les entrées d’aujourd’hui ne ressemblent pas à celles de son entraînement. Toute action automatique demande une évaluation adaptée au domaine.
Le même schéma hors de la finance
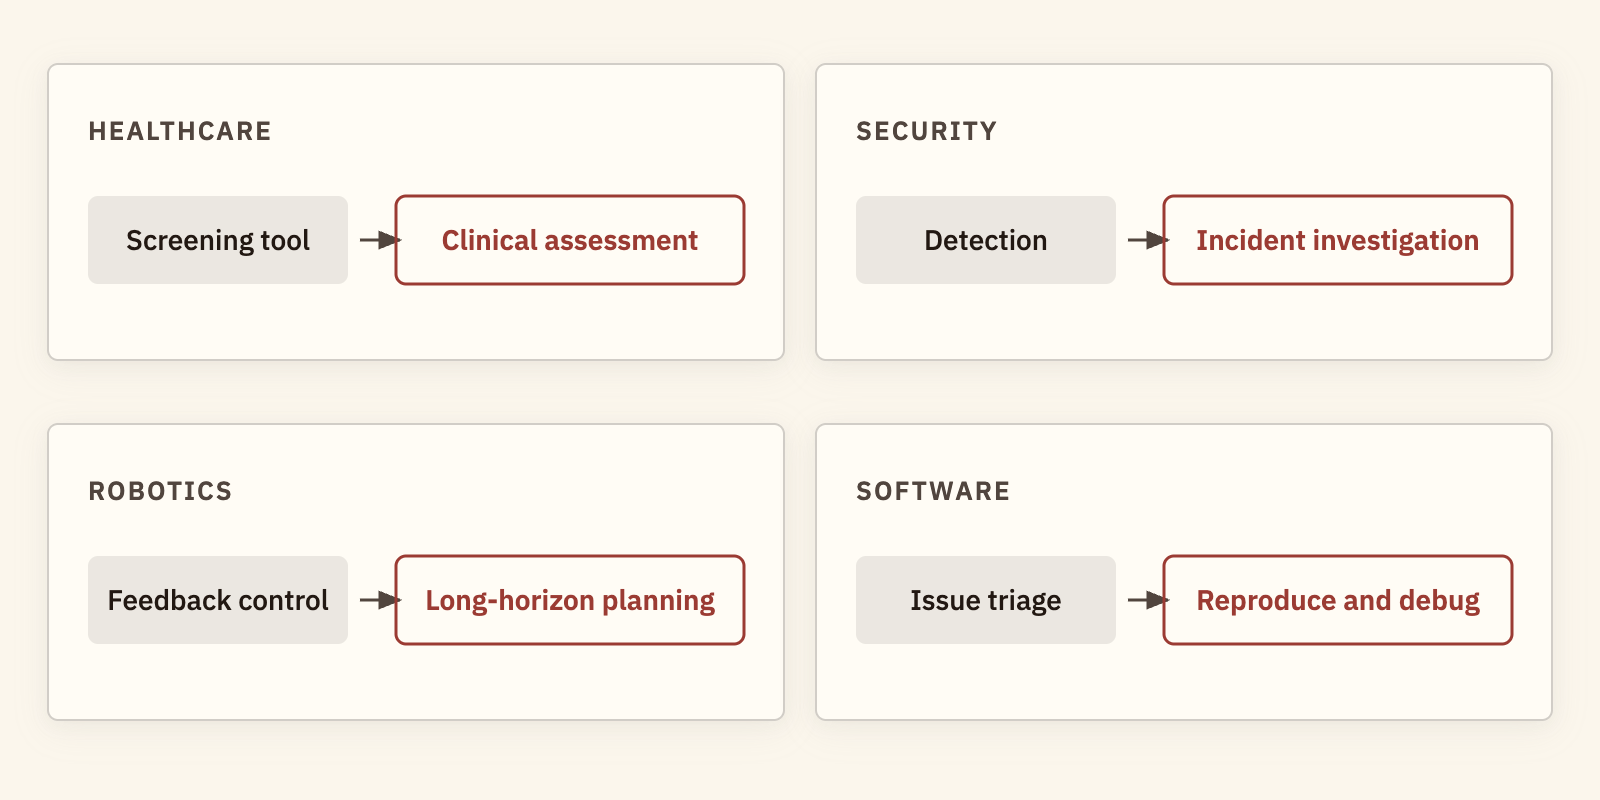
En santé, un outil de dépistage peut faire remonter des cas pour une évaluation clinique au lieu de poser seul un diagnostic. En cybersécurité, une détection à grand volume alimente une investigation d’incident. En robotique, un contrôle par rétroaction rapide coexiste avec une planification à plus long horizon. En logiciel, les tickets entrants sont catégorisés avant un workflow de reproduction et de débogage plus coûteux.
Ce sont des schémas d’architecture. Ils ne prouvent pas qu’un modèle précis est validé pour un déploiement à fort enjeu. La qualité des données, le coût des erreurs, l’auditabilité et les exigences de supervision varient selon le domaine.
Ce que Laya et JEV illustrent
Laya est une référence open source pour des prédictions directes structurées. JEV, de TypesetAI, est une référence propriétaire : il faut donc distinguer ses détails internes de ce qui est documenté publiquement sur son comportement. Ni l’un ni l’autre ne définit ce qu’est une IA de Système 1. Les classifieurs prédictifs, les politiques apprises et les contrôleurs réactifs sont d’autres manières de décider vite.
La question que j’en retiens se transpose partout : qu’est-ce qui doit être appris et prédit immédiatement, qu’est-ce qui doit suivre des règles déterministes, et qu’est-ce qui mérite plus de calcul ou un jugement humain ?
Où j’atterris
Système 1 et Système 2 aident à penser la façon dont un système dépense son calcul. Le but n’est pas de tout décider instantanément, ni de délibérer sur tout. C’est d’appliquer assez de preuves, de calcul et de vérification pour ce que coûte chaque décision quand elle est fausse.
Dans le deuxième article, je descends d’un niveau : comment un réseau de neurones apprend les paramètres derrière ces prédictions rapides.